Vẽ xong mô hình CFA, bấm Calculate Estimates và nhận về CFI = 0,86, RMSEA = 0,091 — hoặc tệ hơn, AMOS báo “The model is probably unidentified”. Nối thêm vài mũi tên hiệp phương sai thì chỉ số đẹp lên, nhưng như vậy có hợp lệ không? Bài viết hướng dẫn AMOS cho luận văn theo đúng quy trình CFA → Model Fit → hội tụ/phân biệt → SEM → trung gian → đa nhóm, kèm cách cải thiện Model Fit được chấp nhận và cách xử lý các lỗi AMOS hay gặp.
- AMOS là gì, khác SPSS và SmartPLS ở đâu?
- Chuẩn bị dữ liệu trên SPSS
- CFA — phân tích nhân tố khẳng định
- Model Fit: chỉ số nào, ngưỡng bao nhiêu?
- Model Fit không đạt: cải thiện thế nào?
- Giá trị hội tụ & phân biệt
- Mô hình cấu trúc SEM
- Kiểm định trung gian bằng Bootstrap
- Phân tích đa nhóm
- Các lỗi AMOS hay báo & cách sửa
1AMOS là gì, khác SPSS và SmartPLS ở đâu?
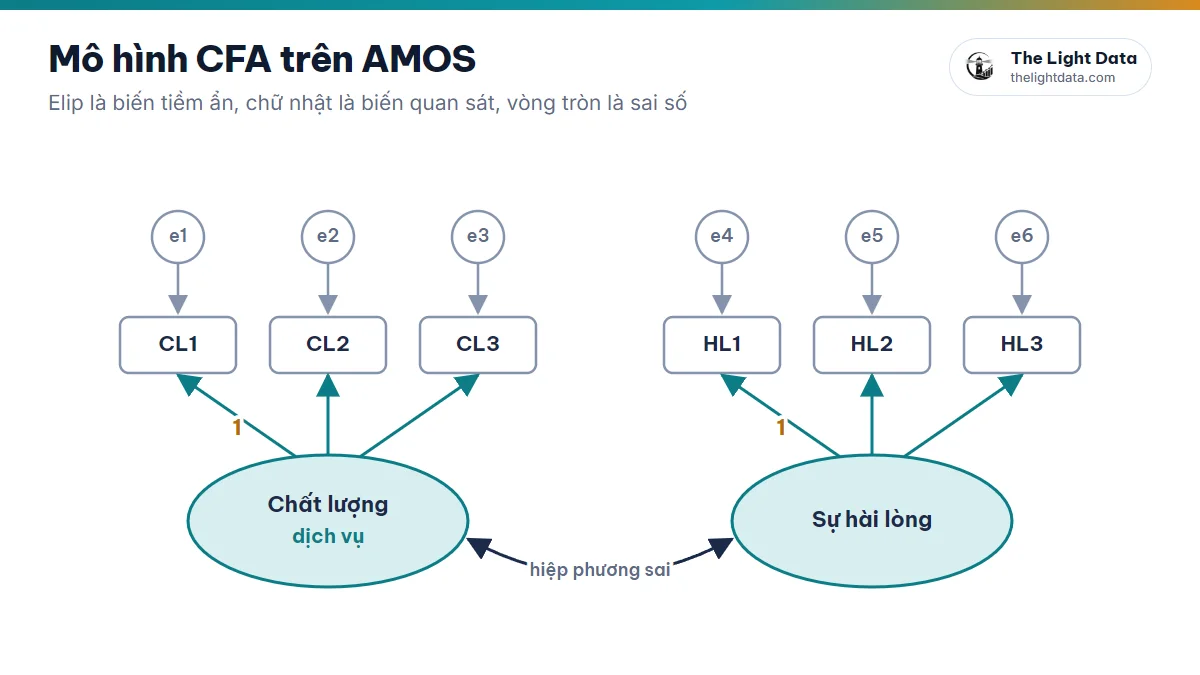
AMOS (Analysis of Moment Structures) là phần mềm phân tích mô hình cấu trúc tuyến tính (SEM) của IBM, đi cùng bộ IBM SPSS Statistics. Bạn xây dựng và kiểm định mô hình bằng cách vẽ sơ đồ: biến tiềm ẩn là hình elip, biến quan sát là hình chữ nhật, quan hệ là mũi tên.
So với SPSS
SPSS mạnh về thống kê truyền thống (Alpha, EFA, hồi quy); AMOS kiểm định đồng thời nhiều quan hệ, tính đến sai số đo lường và tác động trực tiếp, gián tiếp, tổng.
So với SmartPLS
AMOS dùng CB-SEM — phù hợp khi cần khẳng định lý thuyết với bộ chỉ số Model Fit đầy đủ; cần mẫu lớn hơn và dữ liệu gần chuẩn. Xem so sánh chi tiết →
2Chuẩn bị dữ liệu trên SPSS trước khi chạy AMOS
AMOS đọc trực tiếp file .sav. Trước khi phân tích:
- Làm sạch dữ liệu — xử lý Missing, Outlier, phiếu không hợp lệ. Bootstrap và Modification Indices yêu cầu dữ liệu đầy đủ.
- Cronbach’s Alpha — loại biến có tương quan biến – tổng < 0,3.
- EFA — kiểm tra cấu trúc nhân tố (Principal Axis Factoring + Promax thường được khuyến nghị trước CFA).
- Lưu file .sav với tên biến ngắn, không dấu.
3CFA — phân tích nhân tố khẳng định
CFA kiểm định mô hình đo lường: các biến quan sát có thực sự đo đúng biến tiềm ẩn như lý thuyết đề xuất. Khác EFA (khám phá), CFA chỉ thực hiện khi đã có cấu trúc lý thuyết rõ ràng. Qua CFA, bạn đánh giá Model Fit, giá trị hội tụ, phân biệt, CR và AVE.
- Mở AMOS Graphics → File → Data Files → liên kết file .sav.
- Vẽ biến tiềm ẩn (elip) kèm biến quan sát (chữ nhật) bằng công cụ Draw a latent variable or add an indicator — AMOS tự thêm biến sai số và cố định một hệ số tải bằng 1.
- Đặt tên biến quan sát trùng tên biến trong file .sav (List variables in data set, kéo thả).
- Nối hiệp phương sai (mũi tên hai chiều) giữa các biến tiềm ẩn.
- Analysis Properties → Output: tích Standardized estimates, Squared multiple correlations, Modification indices.
- Analyze → Calculate Estimates → View Text Output.
4Model Fit trong AMOS: chỉ số nào, ngưỡng bao nhiêu?
| Chỉ số | Ngưỡng thường dùng | Ngưỡng chặt (Hu & Bentler, 1999) |
|---|---|---|
| CMIN/DF | < 3 (hoặc < 5) | — |
| CFI | ≥ 0,90 | ≥ 0,95 |
| TLI | ≥ 0,90 | ≥ 0,95 |
| RMSEA | ≤ 0,08 | ≤ 0,06 |
| SRMR | ≤ 0,08 | ≤ 0,08 |
| GFI | ≥ 0,90 (≥ 0,80 vẫn được một số tác giả chấp nhận) | — |
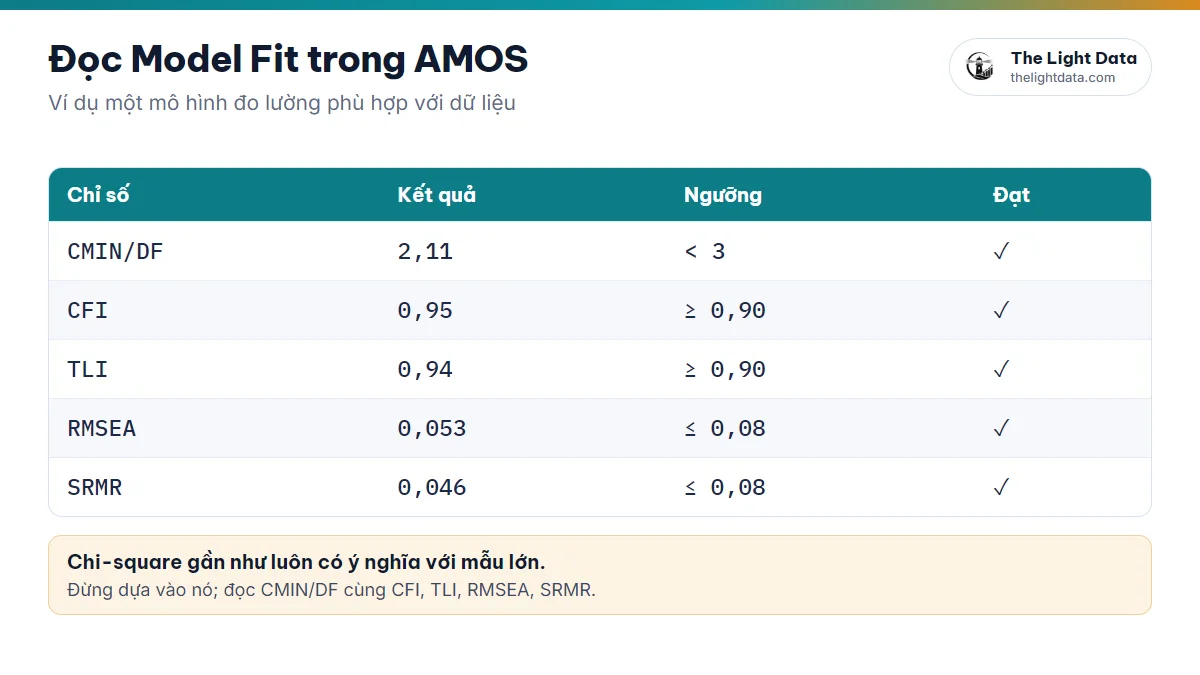
- Chi-square gần như luôn có ý nghĩa với mẫu lớn — đừng dựa vào nó; xem CMIN/DF kèm CFI, TLI, RMSEA, SRMR.
- GFI, AGFI nhạy với cỡ mẫu; nhiều tác giả hiện nay ưu tiên CFI, TLI, RMSEA, SRMR.
- SRMR không có sẵn trong Text Output: dùng Plugins → Standardized RMR rồi chạy lại mô hình.
CMIN/DF = 2,11 · CFI = 0,95 · TLI = 0,94 · RMSEA = 0,053 · SRMR = 0,046 → mô hình đo lường phù hợp với dữ liệu.
5Model Fit không đạt: cải thiện thế nào cho hợp lệ?
- Biến có hệ số tải chuẩn hóa thấp (dưới 0,5): cân nhắc loại từng biến một, ưu tiên biến yếu nhất.
- Modification Indices (M.I.): chỉ nối hiệp phương sai giữa sai số của hai biến cùng một nhân tố khi hai câu có lý do nội dung (cách diễn đạt gần nhau, cùng khía cạnh).
- Không nối sai số giữa hai nhân tố khác nhau, không nối sai số với biến tiềm ẩn.
- Thay đổi từng bước, chạy lại, ghi lại mỗi điều chỉnh và lý do.
Nối tùy tiện theo M.I. có thể làm chỉ số đẹp nhưng mô hình mất ý nghĩa lý thuyết — hội đồng có kinh nghiệm sẽ nhận ra ngay. Mô hình chỉ đạt ngưỡng “thường dùng” vẫn có thể chấp nhận nếu được giải thích hợp lý.
6Kiểm định giá trị hội tụ và giá trị phân biệt
- Hội tụ: hệ số tải chuẩn hóa ≥ 0,5 (ưu tiên ≥ 0,7) · AVE ≥ 0,5 · CR ≥ 0,7
- Phân biệt: căn bậc hai AVE > tương quan giữa các nhân tố (Fornell–Larcker), hoặc HTMT < 0,85
“Chất lượng dịch vụ” (CL1–CL4): hệ số tải đều > 0,7 · AVE = 0,65 · CR = 0,88 → đạt hội tụ và độ tin cậy.
AMOS không xuất trực tiếp CR, AVE, HTMT: tính từ hệ số tải chuẩn hóa và ma trận tương quan bằng bảng tính hoặc plugin.
7Mô hình cấu trúc tuyến tính (SEM)
Từ mô hình CFA đã đạt, thay các hiệp phương sai giữa biến tiềm ẩn bằng mũi tên giả thuyết, thêm sai số cho biến nội sinh rồi chạy lại. Kết quả cần đọc: Standardized Regression Weights, C.R. (Critical Ratio, |C.R.| > 1,96 ~ p < 0,05), P và Squared Multiple Correlations (R²).
Chất lượng dịch vụ → Sự hài lòng: β = 0,62 · C.R. = 8,45 · P < 0,001 (AMOS hiển thị “***”) → tác động tích cực, có ý nghĩa thống kê.
8Kiểm định tác động trung gian bằng Bootstrap
Tác động gián tiếp có ý nghĩa khi khoảng tin cậy Bootstrap không chứa 0.
Chất lượng dịch vụ → Sự hài lòng → Lòng trung thành: Indirect Effect = 0,31 · 95% CI = [0,18; 0,45] → Sự hài lòng là biến trung gian.
- Analysis Properties → Output: tích Indirect, direct & total effects.
- Tab Bootstrap: tích Perform bootstrap, số mẫu 2.000–5.000, Bias-corrected confidence intervals 95%.
- Chạy mô hình, xem Estimates → Matrices → Indirect Effects kèm phần Bootstrap (Lower/Upper bounds, P).
Muốn tách riêng từng đường gián tiếp khi mô hình có nhiều biến trung gian, dùng User-defined estimands hoặc plugin chuyên dụng.
9Phân tích đa nhóm (Multi-Group Analysis)
So sánh mô hình giữa các nhóm (nam/nữ, khách hàng mới/cũ…) để xem các quan hệ có khác nhau không.
Động lực học tập → Kết quả học tập: β Nam = 0,58 · β Nữ = 0,42. Để kết luận khác biệt có ý nghĩa, so sánh mô hình bất biến (ràng buộc hệ số bằng nhau) với mô hình khả biến bằng chênh lệch Chi-square: P < 0,05 → khác biệt có ý nghĩa.
- Chuẩn bị biến phân nhóm trong SPSS.
- Analyze → Manage Groups tạo các nhóm; Data Files → Grouping Variable gán giá trị cho từng nhóm.
- Analyze → Multiple-Group Analysis để AMOS tạo các mô hình ràng buộc.
- So sánh mô hình qua Model Comparison (chênh lệch Chi-square và P).
10Các lỗi AMOS hay báo và cách sửa
| Thông báo / hiện tượng | Nguyên nhân & cách sửa |
|---|---|
| “The model is probably unidentified” | Chưa cố định một hệ số tải bằng 1 cho mỗi nhân tố, thiếu biến sai số, hoặc nhân tố quá ít biến quan sát |
| Không chạy được Bootstrap / Modification Indices | Dữ liệu có giá trị thiếu — xử lý Missing trong SPSS rồi liên kết lại .sav |
| Biến quan sát không khớp dữ liệu | Tên biến trên sơ đồ khác tên trong .sav — kéo thả từ List variables in data set |
| Phương sai âm (Heywood case) | Mẫu nhỏ, nhân tố chỉ 2 biến hoặc mô hình chưa đúng — xem lại cấu trúc và cỡ mẫu |
| Hệ số tải chuẩn hóa > 1 | Thường đi kèm phương sai âm; kiểm tra đa cộng tuyến giữa biến quan sát |
Hình dung bảng AMOS trước khi chạy thật
Trên bàn vẽ mô hình của The Light Data, chọn phương pháp AMOS để xem bộ bảng Model Fit, hệ số chuẩn hóa và Bootstrap cho mô hình của bạn trên dữ liệu mô phỏng — tiện để luyện đọc và dàn ý chương 4 (không dùng thay dữ liệu thật).
- Quy trình: dữ liệu sạch (.sav) → CFA → Model Fit → hội tụ/phân biệt → SEM → trung gian → đa nhóm.
- Model Fit: CMIN/DF < 3 · CFI, TLI ≥ 0,90 · RMSEA, SRMR ≤ 0,08.
- Cải thiện fit có căn cứ: loại biến tải thấp, chỉ nối sai số cùng nhân tố khi có lý do nội dung.
- Giả thuyết được ủng hộ khi |C.R.| > 1,96 và P < 0,05; trung gian khi khoảng tin cậy Bootstrap không chứa 0.