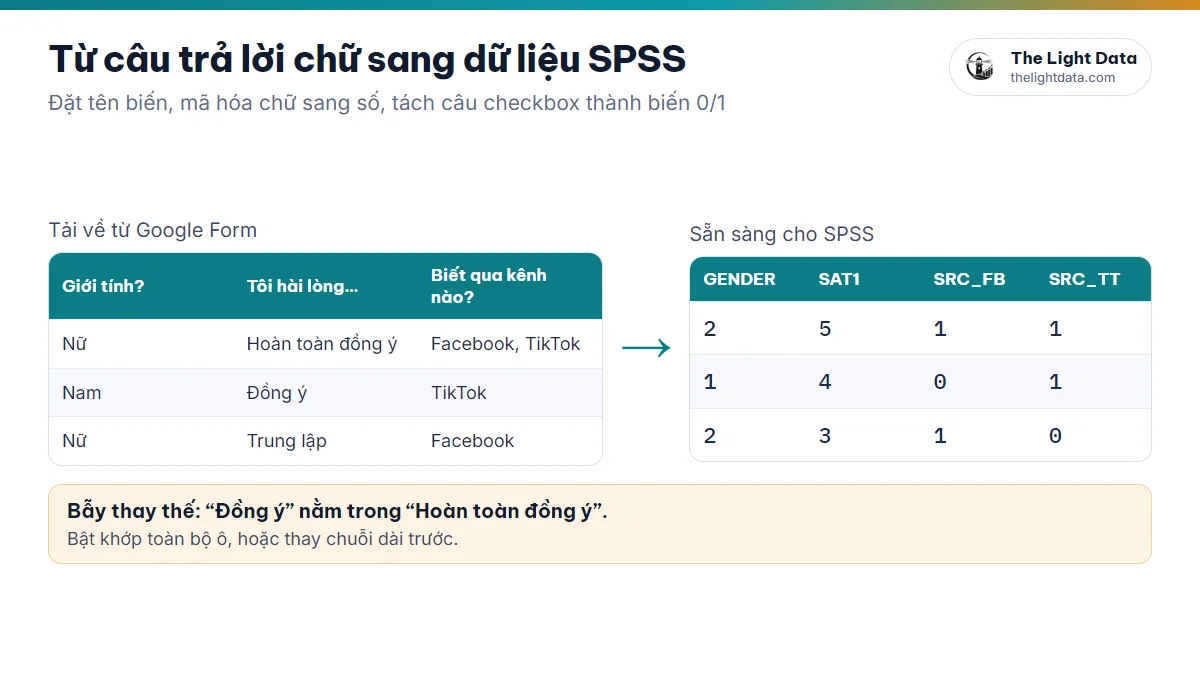
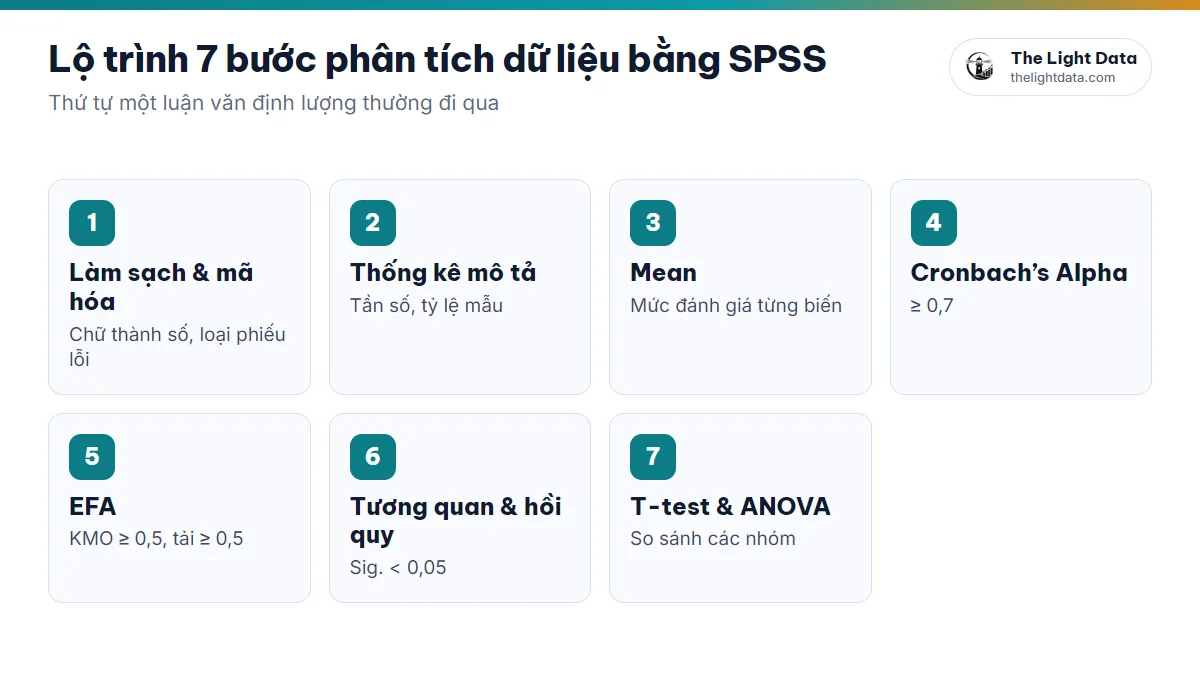
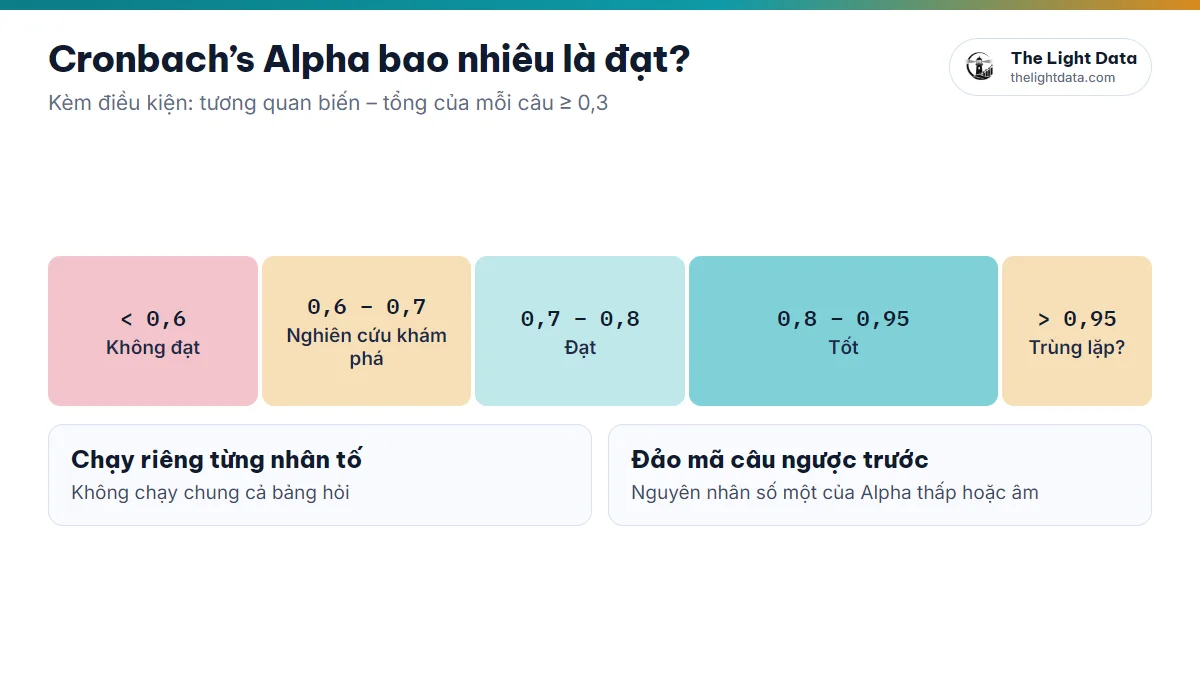
Cronbach’s Alpha ra số âm. Bảng tần số toàn “1, 2, 3” mà không ai biết là gì. Chạy lại lần thứ ba vẫn sai vì cột thu nhập lẫn chữ và số. Phần lớn các lỗi “khó hiểu” trong SPSS bắt nguồn từ một chỗ: khâu mã hóa và khai báo dữ liệu đầu vào. Bài viết tổng hợp quy tắc mã hóa từng loại biến, đặt tên biến chuẩn SPSS, gán nhãn và khai báo Missing — làm đúng một lần để không phải chạy lại.
1Vì sao phải mã hóa dữ liệu trước khi phân tích?
Theo Pallant (2020), chuẩn bị và làm sạch dữ liệu là bước đầu tiên và quan trọng nhất — chất lượng kết quả phụ thuộc trực tiếp vào chất lượng dữ liệu đầu vào. Dữ liệu khảo sát thường ở dạng chữ (“Nam”, “Nữ”, “Đồng ý”), có ô trống hoặc câu trả lời không hợp lệ, trong khi SPSS chỉ tính toán được trên mã số đúng kiểu.
- SPSS nhận diện chính xác kiểu biến, chạy được Mean, Alpha, EFA, hồi quy
- Giảm sai sót nhập liệu, dễ phát hiện giá trị lạ, Missing, Outlier
- Kết quả dễ đọc nhờ nhãn, dễ tái lập khi giảng viên yêu cầu kiểm tra
2Cách mã hóa dữ liệu khảo sát theo từng loại biến
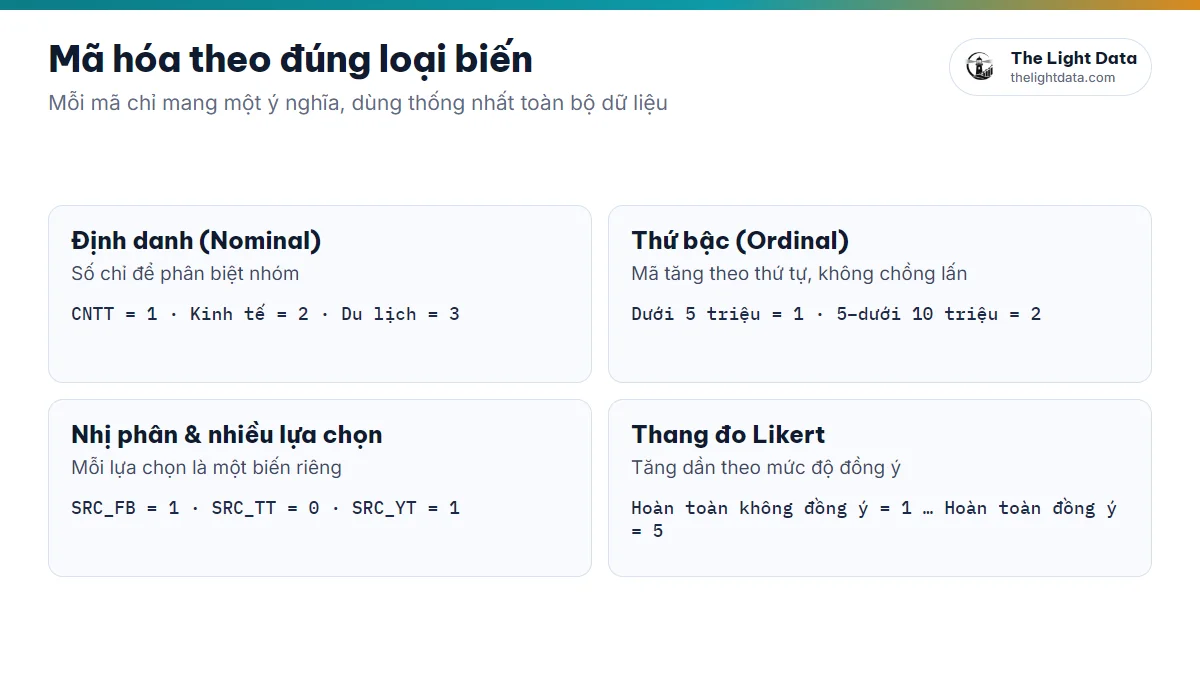
Theo Field (2018), mã hóa là chuyển câu trả lời thành giá trị số; mỗi giá trị chỉ mang một ý nghĩa và được dùng thống nhất trong toàn bộ dữ liệu.
Biến định danh (Nominal)
Không có thứ tự; con số chỉ để phân biệt nhóm, không thể hiện lớn hay nhỏ.
| Khoa | Mã |
|---|---|
| Công nghệ thông tin | 1 |
| Kinh tế | 2 |
| Ngoại ngữ | 3 |
| Du lịch | 4 |
Biến thứ bậc (Ordinal)
Có thứ tự nhưng khoảng cách giữa các mức không nhất thiết bằng nhau; mã số phải tăng theo đúng thứ tự. Các khoảng không được chồng lấn.
| Thu nhập / tháng | Mã |
|---|---|
| Dưới 5 triệu | 1 |
| Từ 5 – dưới 10 triệu | 2 |
| Từ 10 – dưới 15 triệu | 3 |
| Từ 15 – dưới 20 triệu | 4 |
| Từ 20 triệu trở lên | 5 |
Biến nhị phân và câu hỏi nhiều lựa chọn
Biến nhị phân mã hóa 0/1 hoặc 1/2 (VD: đã từng mua online — Chưa = 0, Đã từng = 1). Câu hỏi nhiều lựa chọn: tách mỗi phương án thành một biến riêng (1 = có chọn, 0 = không chọn).
| ID | SRC_FB | SRC_TT | SRC_YT |
|---|---|---|---|
| 1 | 1 | 0 | 1 |
| 2 | 0 | 1 | 1 |
Thang đo Likert
Mọi câu trong cùng thang đo dùng chung một quy ước, tăng dần theo mức độ đồng ý — điều kiện bắt buộc cho Cronbach’s Alpha, EFA, CFA hay SmartPLS.
| Giá trị | Ý nghĩa |
|---|---|
| 1 | Hoàn toàn không đồng ý |
| 2 | Không đồng ý |
| 3 | Trung lập |
| 4 | Đồng ý |
| 5 | Hoàn toàn đồng ý |
3Câu hỏi đảo ngược: đảo mã thế nào cho đúng?
Câu đảo ngược (reverse item) như “Tôi thấy thủ tục mua hàng rườm rà” đo cùng khái niệm nhưng ngược chiều. Nếu không đảo mã, câu này tương quan âm với các câu còn lại — Alpha tụt mạnh, thậm chí âm.
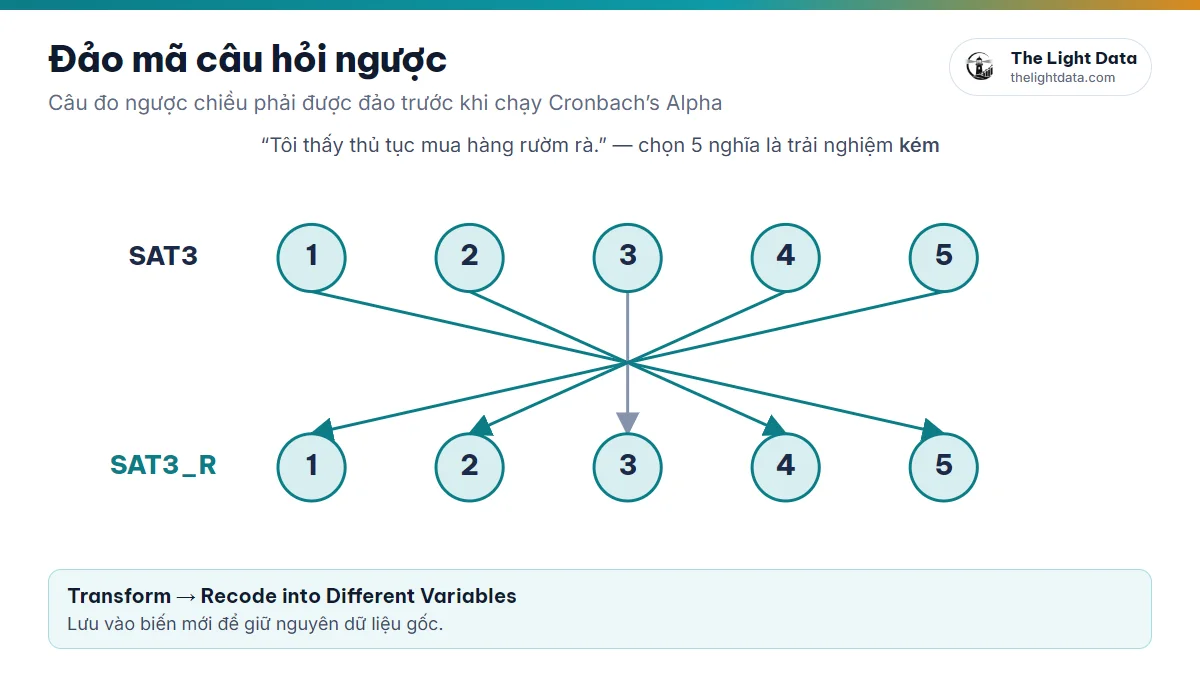
- Transform→Recode into Different Variables→Old and New Values
- Khai báo 1→5, 2→4, 3→3, 4→2, 5→1.
- Đặt tên biến mới có hậu tố _R (VD: SAT3_R) để giữ nguyên biến gốc, rồi dùng biến mới trong phân tích.
Sửa tay từng ô vừa lâu vừa dễ sót. Recode có thể lưu lại bằng Paste thành cú pháp (Syntax) để chạy lại hoặc chứng minh cách xử lý khi cần.
4Quy tắc đặt tên biến chuẩn SPSS
Theo IBM (2023), tên biến phải tuân thủ quy tắc cú pháp:
- Bắt đầu bằng chữ cái; không khoảng trắng; không dấu tiếng Việt
- Không chứa ký tự đặc biệt như % # & / ? ! *
- Không trùng nhau, không trùng từ khóa của SPSS (AND, OR, NOT, ALL, BY…)
- Ngắn gọn, viết tắt tiếng Anh thống nhất
| Không nên đặt | Nên đặt |
|---|---|
| Câu 1 | Q1 |
| Tuổi của bạn | AGE |
| Giới tính | GENDER |
| Mức độ hài lòng | SAT |
| Ý định mua hàng | PI |
Đặt tên theo nhóm nhân tố
Cấu trúc mã nhân tố + số thứ tự giúp chọn biến nhanh khi chạy Cronbach’s Alpha, EFA, CFA hay SmartPLS:
| Nhân tố | Biến |
|---|---|
| Functional Value | FV1, FV2, FV3, FV4 |
| Social Value | SV1, SV2, SV3 |
| Physical Risk | PR1, PR2, PR3 |
| Purchase Intention | PI1, PI2, PI3 |
5Gán nhãn biến và nhãn giá trị (Labels)
Variable Label mô tả đầy đủ nội dung câu hỏi; Value Labels khai báo ý nghĩa từng mã — nhờ đó bảng kết quả hiện “Nam/Nữ” thay vì “1/2”.
Variable Label
| Tên biến | Nhãn |
|---|---|
| FV1 | Sản phẩm đáng giá với số tiền bỏ ra |
| PI1 | Tôi dự định mua sản phẩm trong thời gian tới |
Value Labels
| Value | Label |
|---|---|
| 1 / 2 | GENDER: Nam / Nữ |
| 1 … 5 | Likert: Hoàn toàn không đồng ý … Hoàn toàn đồng ý |
6Khai báo Missing và Measure trong Variable View
Missing
Để trống (system-missing) hoặc dùng mã không trùng giá trị hợp lệ (VD: 99) và khai báo trong cột Missing. Nếu không khai báo, SPSS sẽ tính 99 như một câu trả lời thật — Mean bị kéo lệch.
Measure
- Nominal: giới tính, khoa, nghề nghiệp
- Ordinal: thu nhập, độ tuổi theo khoảng
- Scale: số liệu định lượng; câu Likert khi tính trung bình, chạy hồi quy
7Lập Codebook và mã hóa dữ liệu tự động
Codebook là bảng ghi tên biến, nội dung câu hỏi, bảng mã và cách xử lý Missing. Nó giúp bạn đọc kết quả chính xác, giúp người hướng dẫn kiểm tra nhanh và thường được đưa vào phụ lục luận văn.
Nếu dữ liệu đến từ Google Form, công cụ Mã hóa dữ liệu SPSS của The Light Data làm sẵn các bước trên: AI đọc biểu mẫu, đề xuất tên biến hợp lệ và bảng mã cho từng câu, tách câu checkbox thành biến 0/1, rồi xuất file Excel đã mã hóa kèm sheet Codebook để mở thẳng bằng SPSS. Bạn xem lại toàn bộ kế hoạch mã hóa trước khi xuất file.
- Mã hóa đúng loại biến; Likert tăng dần theo mức độ đồng ý; checkbox tách thành biến 0/1.
- Đảo mã câu ngược bằng Recode vào biến mới (_R) trước khi chạy Alpha.
- Tên biến ngắn, hợp lệ, theo mã nhân tố; đủ Label, Values, Missing, Measure.
- Lưu Codebook — dữ liệu sạch thì Cronbach’s Alpha, EFA, hồi quy, SEM mới đáng tin.