Lần đầu mở SPSS, màn hình như bảng Excel nhưng menu thì dày đặc thuật ngữ. Chạy cái gì trước, cái gì sau? Đọc bảng nào? Sig. bao nhiêu là được? Đây là hướng dẫn SPSS từ A–Z cho người mới, đi theo đúng lộ trình 7 bước của một luận văn định lượng — mỗi bước có ngưỡng đánh giá, ví dụ và thao tác cụ thể.
- SPSS là gì, vì sao luận văn hay dùng?
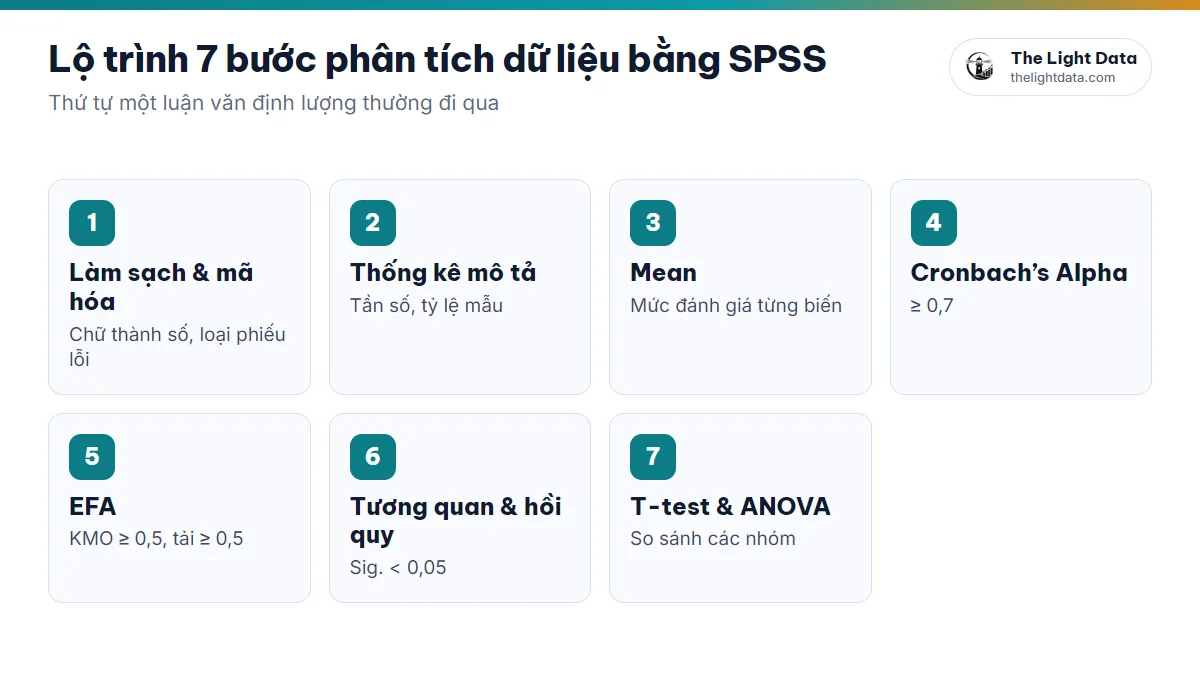
- Lộ trình 7 bước phân tích dữ liệu
- Bước 1 — Làm sạch & mã hóa dữ liệu
- Bước 2 — Thống kê mô tả
- Bước 3 — Thống kê trung bình (Mean)
- Bước 4 — Cronbach’s Alpha
- Bước 5 — Phân tích EFA
- Bước 6 — Tương quan Pearson & hồi quy
- Bước 7 — T-test & ANOVA
- 5 lỗi người mới hay mắc
1SPSS là gì, vì sao luận văn hay dùng?
SPSS (Statistical Package for the Social Sciences) là phần mềm phân tích thống kê của IBM (IBM SPSS Statistics), cho phép xử lý và phân tích dữ liệu bằng giao diện bấm chuột, không cần lập trình. SPSS được dùng rộng rãi trong kinh tế, quản trị, giáo dục, tâm lý học, xã hội học, y tế và marketing.
Ưu điểm
- Giao diện thân thiện, menu rõ ràng
- Đủ phép phân tích từ cơ bản đến nâng cao
- Xuất bảng và biểu đồ thuận tiện
- Được chấp nhận rộng rãi trong luận văn, bài báo
Ứng dụng phổ biến
- Khảo sát sự hài lòng, chất lượng dịch vụ
- Hành vi tiêu dùng, ý định mua hàng
- Kết quả học tập, phương pháp giảng dạy
- So sánh nhóm đối tượng trong y tế, xã hội
2Lộ trình 7 bước phân tích dữ liệu luận văn bằng SPSS
Đề tài dùng AMOS hoặc SmartPLS vẫn đi qua bước ①–⑤ trên SPSS (hoặc chuyển thẳng sang SmartPLS sau bước ②). Xem hướng dẫn AMOS và SmartPLS là gì.
3Bước 1 — Làm sạch và mã hóa dữ liệu đầu vào
Trước khi phân tích, dữ liệu cần được chuẩn hóa. Quy trình gồm 5 việc:
- Kiểm tra dữ liệu — số lượng mẫu, dữ liệu thiếu (Missing), nhập sai, phiếu trùng
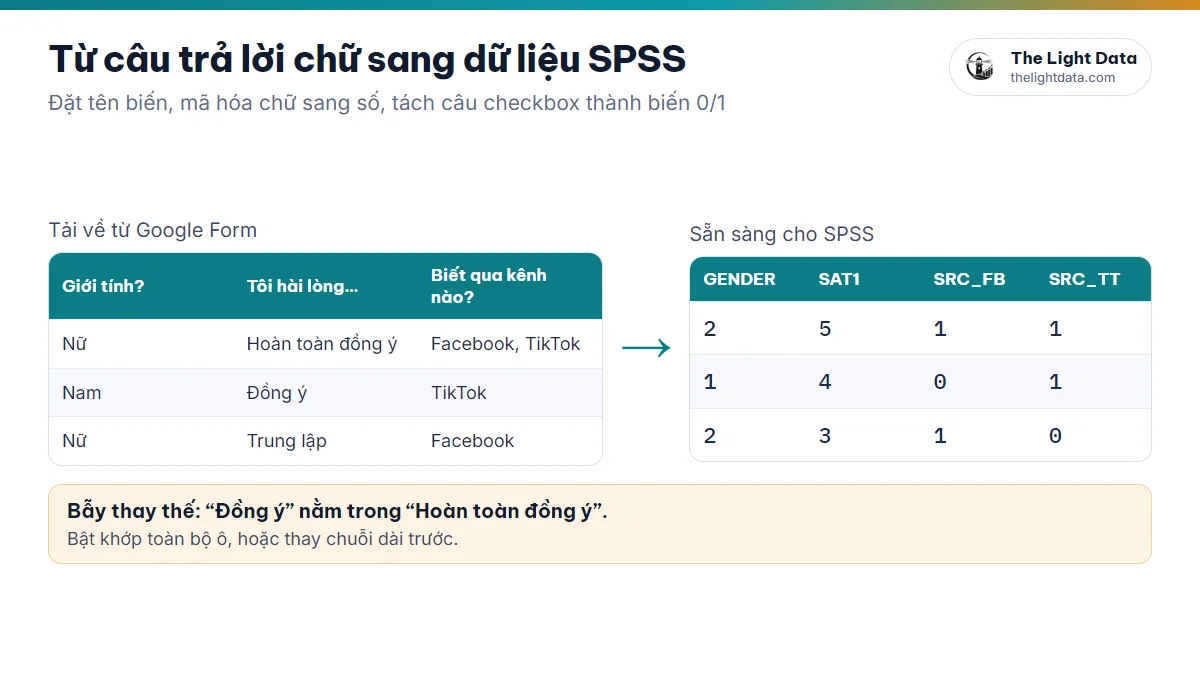
- Mã hóa biến — chuyển câu trả lời thành số (Nam = 1, Nữ = 2; Likert 1–5)
- Khai báo biến trong Variable View — Name, Label, Values, Missing, Measure
- Kiểm tra ngoại lai (Outlier) — Boxplot, Explore, Z-score
- Lưu dữ liệu — .sav
Mã hóa sai chiều thang Likert hay quên đảo mã câu ngược sẽ làm sai toàn bộ phân tích phía sau — mà SPSS không hề báo lỗi.
4Bước 2 — Thống kê mô tả (Descriptive Statistics)
Tóm tắt đặc điểm mẫu khảo sát: giới tính, độ tuổi, thu nhập… thường là bảng đầu tiên của chương 4.
Khảo sát 200 sinh viên:
| Giới tính | Số lượng | Tỷ lệ (%) |
|---|---|---|
| Nam | 90 | 45 |
| Nữ | 110 | 55 |
- Biến định tính: Analyze→Descriptive Statistics→Frequencies
- Biến định lượng: Analyze→Descriptive Statistics→Descriptives → Options: Mean, SD, Min, Max
5Bước 3 — Thống kê trung bình (Mean) thang Likert
Cho biết mức độ đánh giá trung bình với từng biến/nhân tố, trình bày kèm độ lệch chuẩn (SD). Với Likert 5 mức, một cách diễn giải hay dùng:
- Mean < 2,5 — Mức thấp
- 2,5 – < 3,5 — Trung bình
- Mean ≥ 3,5 — Cao
“Tôi hài lòng với chất lượng giảng dạy”: Mean = 4,12 · SD = 0,68 → người khảo sát có xu hướng đồng ý.
6Bước 4 — Kiểm định độ tin cậy Cronbach’s Alpha
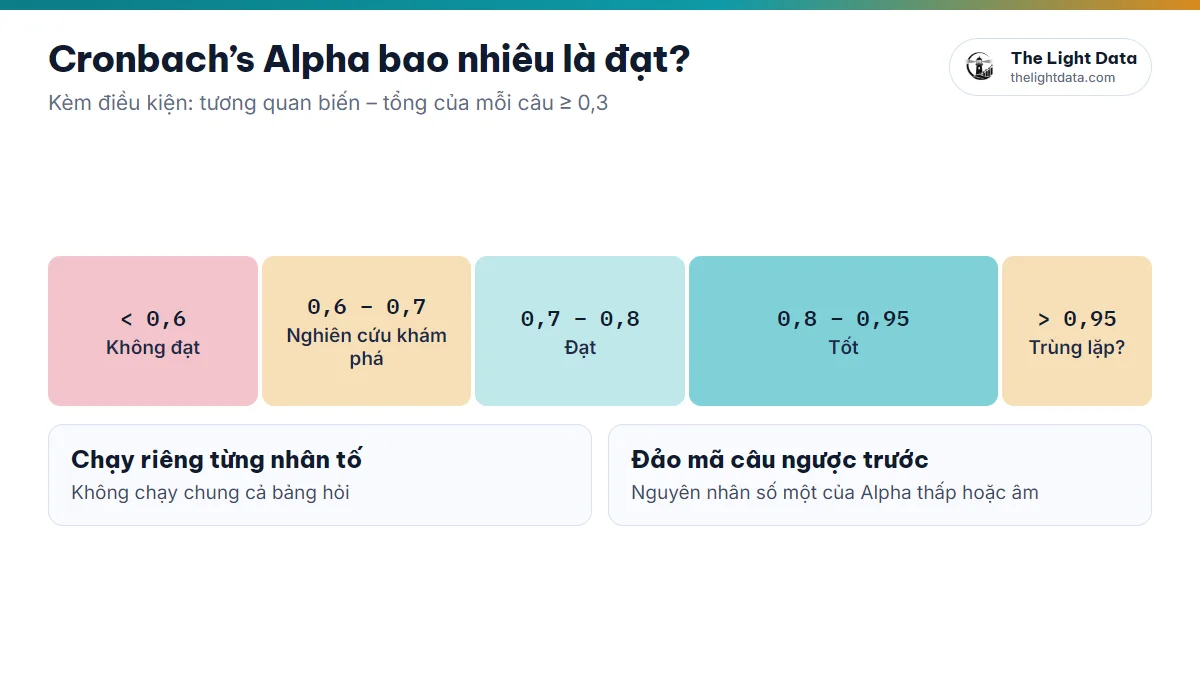
Kiểm tra các câu trong cùng một nhân tố có đo lường nhất quán hay không. Tiêu chuẩn: Alpha ≥ 0,7 (≥ 0,6 với nghiên cứu khám phá) và tương quan biến – tổng ≥ 0,3.
- Analyze→Scale→Reliability Analysis
- Statistics: Item, Scale, Scale if item deleted — chạy riêng từng nhân tố.
7Bước 5 — Phân tích nhân tố khám phá EFA
Kiểm tra giá trị hội tụ và phân biệt của thang đo sau khi đạt Cronbach’s Alpha.
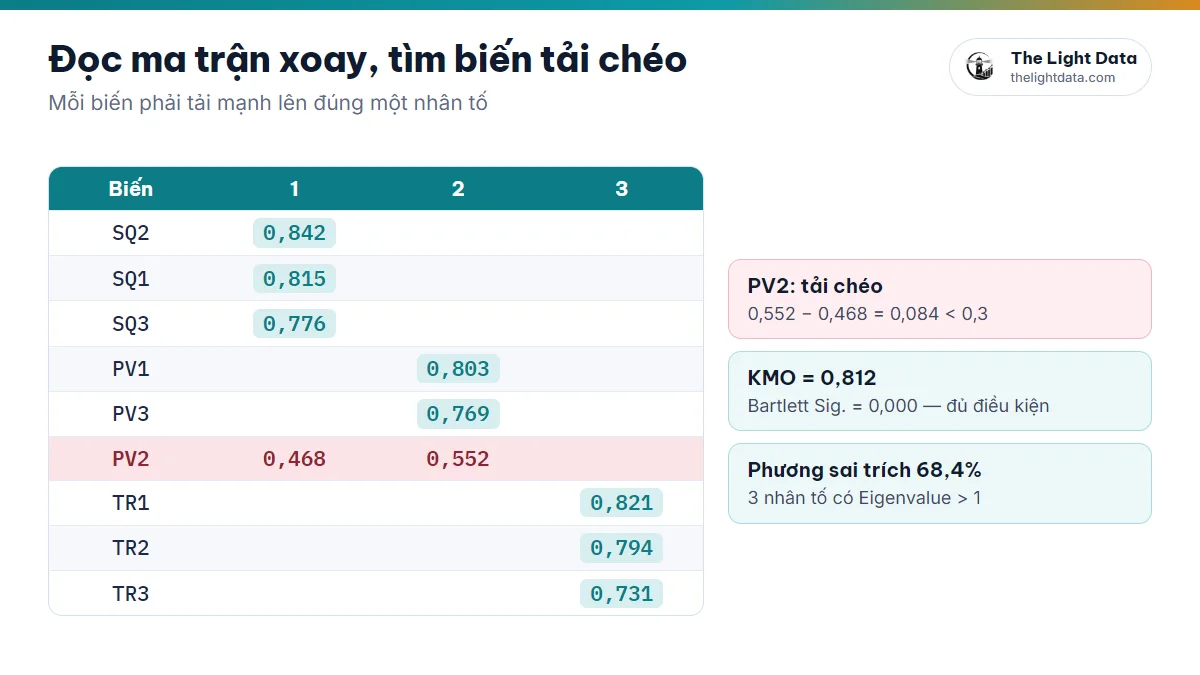
- KMO ≥ 0,5 · Bartlett Sig. < 0,05
- Eigenvalue > 1 · Tổng phương sai trích ≥ 50%
- Hệ số tải ≥ 0,5, mỗi biến tải lên đúng một nhân tố
- Analyze→Dimension Reduction→Factor
- Descriptives: KMO and Bartlett · Extraction: Principal components, Eigenvalue > 1 · Rotation: Varimax · Options: Sorted by size, Suppress 0,3
8Bước 6 — Tương quan Pearson và hồi quy tuyến tính bội
Tương quan Pearson
Đánh giá mức độ và chiều hướng quan hệ tuyến tính giữa các biến (r từ −1 đến 1). Sig. < 0,05 → tương quan có ý nghĩa. Biến độc lập cần tương quan có ý nghĩa với biến phụ thuộc; tương quan giữa các biến độc lập quá cao (trên khoảng 0,8) là dấu hiệu đa cộng tuyến.
- Analyze→Correlate→Bivariate → Pearson · Two-tailed
Hồi quy tuyến tính bội
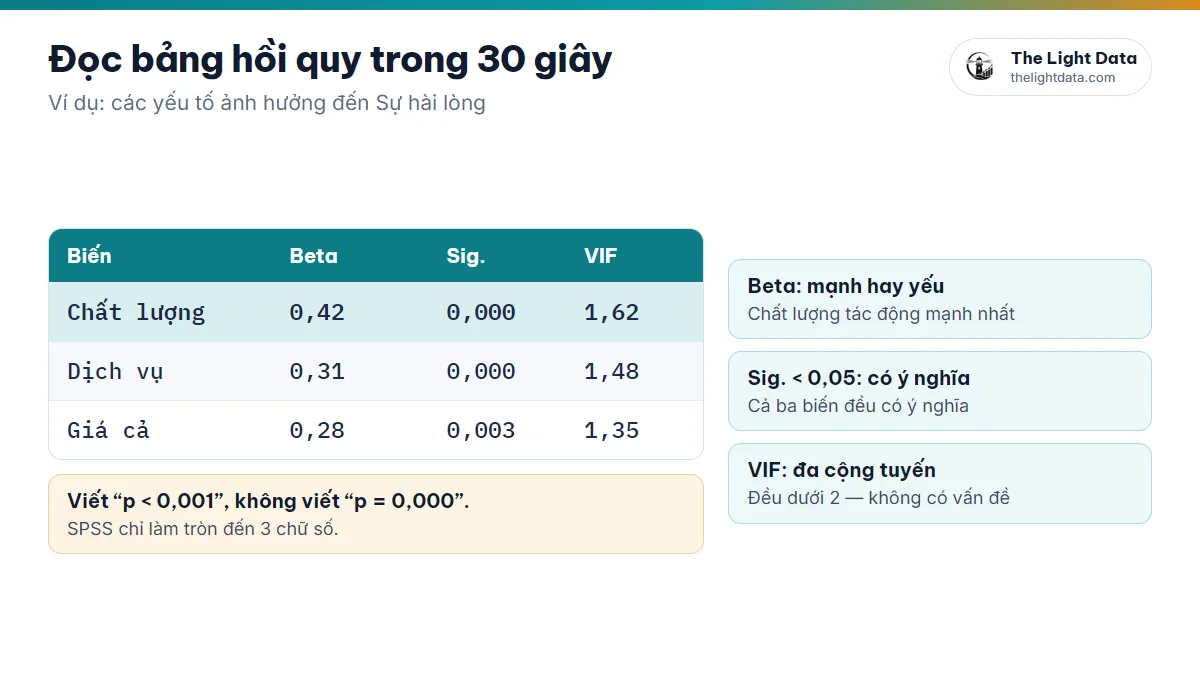
Xác định mức độ ảnh hưởng của các biến độc lập đến biến phụ thuộc và kiểm định giả thuyết.
| Biến | Beta chuẩn hóa | Sig. | VIF |
|---|---|---|---|
| Chất lượng | 0.42 | 0.000 | 1.62 |
| Dịch vụ | 0.31 | 0.000 | 1.48 |
| Giá cả | 0.28 | 0.003 | 1.35 |
Cả ba nhân tố tác động tích cực, có ý nghĩa (Sig. < 0,05); Chất lượng tác động mạnh nhất (Beta lớn nhất); VIF < 2 → không đa cộng tuyến.
- Phần dư phân phối chuẩn: Histogram, Normal P-P Plot.
- Phương sai phần dư không đổi: Scatterplot giữa phần dư chuẩn hóa và giá trị dự đoán chuẩn hóa.
- Không đa cộng tuyến: VIF nhỏ (thường < 10, chặt chẽ hơn là < 5 hoặc < 3).
- Độc lập phần dư: Durbin–Watson trong khoảng 1,5–2,5.
- Analyze→Regression→Linear
- Statistics: Estimates · Model fit · Collinearity diagnostics · Durbin-Watson
- Plots: ZRESID (Y) – ZPRED (X) · Histogram · Normal probability plot
9Bước 7 — Kiểm định khác biệt: T-test và ANOVA
Kiểm tra các nhóm (giới tính, độ tuổi, thu nhập…) có khác biệt về giá trị trung bình của một biến hay không.
Independent Samples T-test — so sánh 2 nhóm
Đọc kiểm định Levene trước: Sig. Levene ≥ 0,05 → đọc dòng Equal variances assumed; < 0,05 → đọc dòng not assumed. Sau đó Sig. (2-tailed) < 0,05 → có khác biệt.
- Analyze→Compare Means→Independent-Samples T Test
- Test Variable: biến định lượng · Grouping Variable: biến nhóm → Define Groups: 1 và 2
One-way ANOVA — so sánh từ 3 nhóm trở lên
Levene Sig. ≥ 0,05 → đọc bảng ANOVA, kiểm định sau bằng Tukey/Bonferroni; Levene Sig. < 0,05 → đọc kiểm định Welch (Robust Tests) và kiểm định sau Games-Howell.
- Analyze→Compare Means→One-Way ANOVA
- Options: Descriptive · Homogeneity of variance test · Welch
- Post Hoc: Tukey (phương sai đồng nhất) · Games-Howell (không đồng nhất)
105 lỗi người mới học SPSS hay mắc
| Lỗi | Cách làm đúng |
|---|---|
| Ghi “p = 0,000” trong báo cáo | Ghi “p < 0,001” — SPSS chỉ làm tròn đến 3 chữ số |
| Chạy Cronbach chung cả bảng hỏi | Chạy riêng cho từng nhân tố |
| Dùng Automatic Recode cho câu Likert | Recode into Different Variables với bảng mã rõ ràng |
| Bỏ qua kiểm định Levene khi T-test/ANOVA | Đọc Levene trước để chọn đúng dòng/kiểm định |
| Đưa điểm từng câu thay vì điểm nhân tố vào hồi quy | Tạo biến đại diện: Transform → Compute Variable → MEAN(SQ1, SQ2, SQ3) |
Học nhanh hơn với dữ liệu mô phỏng
Muốn thấy trước bộ bảng SPSS của mô hình mình — Cronbach’s Alpha, ma trận xoay, tương quan, hồi quy — để làm quen cách đọc? Hãy vẽ mô hình trên bàn vẽ mô hình của The Light Data và xem kết quả trên dữ liệu mô phỏng (chỉ dùng để học, không thay dữ liệu thật).
- Lộ trình: làm sạch & mã hóa → mô tả → Mean → Cronbach → EFA → tương quan & hồi quy → T-test & ANOVA.
- Mỗi bước có ngưỡng rõ ràng: Alpha ≥ 0,7 · KMO ≥ 0,5 · hệ số tải ≥ 0,5 · Sig. < 0,05 · VIF nhỏ.
- Kiểm tra giả định hồi quy và Levene trước khi kết luận.